Галерея контента · №112
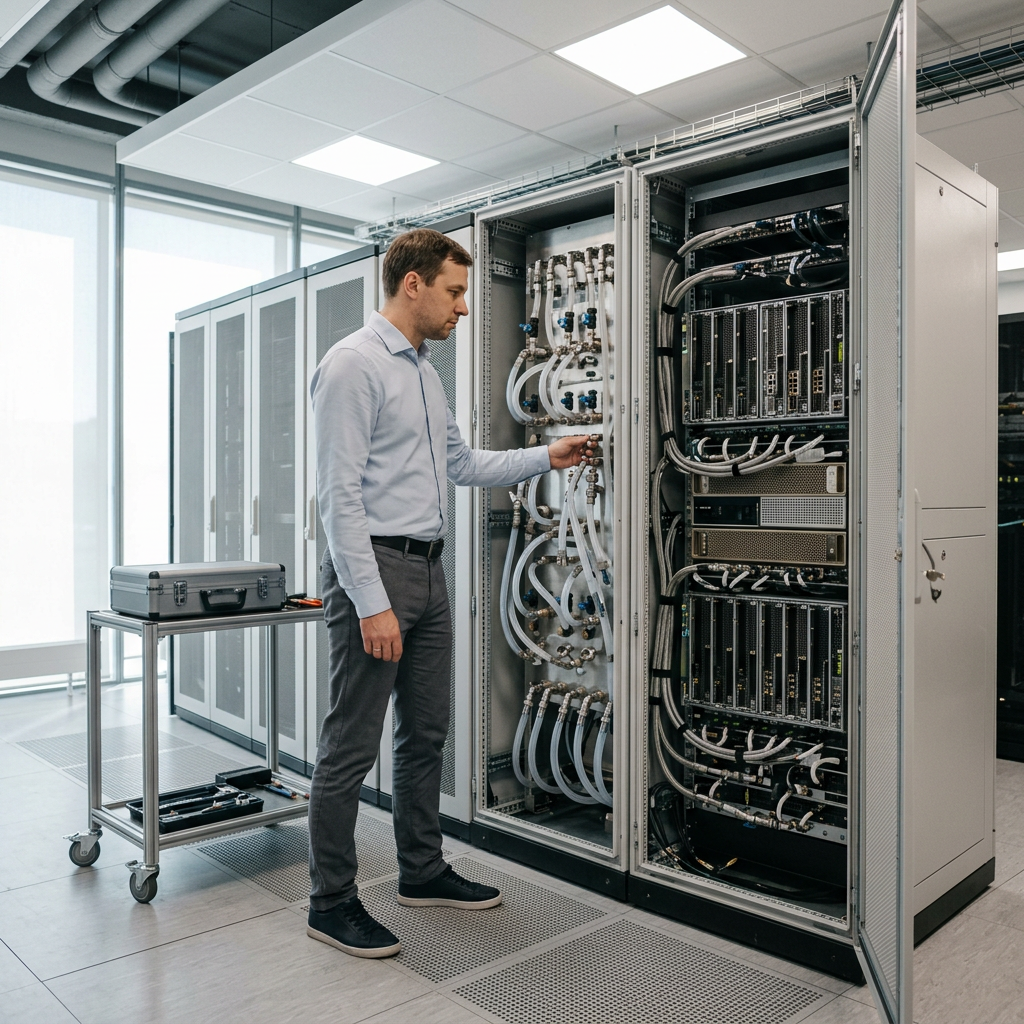
NVIDIA DGX GB300 NVL72: 72 GPU и 20 ТБ памяти в одной стойке
6 октября 2026 г. в 11:44
72 GPU в одной стойке: что стоит за мощностью NVIDIA DGX GB300 NVL72
Вы ищете самый мощный GPU-сервер — и вместо привычного корпуса перед вами оказывается целая стойка. Именно так меняется масштаб вычислений для искусственного интеллекта: производительность определяет уже не отдельный ускоритель, а совместная работа десятков GPU, процессоров, памяти и скоростных соединений. NVIDIA DGX GB300 NVL72 — один из кандидатов для такого разговора. Но назвать его новейшим доступным сервером и безусловным мировым рекордсменом на основании имеющихся данных нельзя.
Это не уход от ответа, а необходимая точность. «Самый мощный» для обучения большой языковой модели, обслуживания тысяч запросов и научных расчётов высокой точности — три разных требования. Чтобы выбрать систему, нужно смотреть не только на эффектные пиковые показатели, но и на то, какую работу она выполняет, в каком режиме и с какими ограничениями.
Не сервер побольше, а другой масштаб системы
DGX GB300 NVL72 правильнее рассматривать как вычислительную систему масштаба стойки. В описании конфигурации, на котором основан этот разбор, указаны 72 GPU NVIDIA Blackwell Ultra и 36 процессоров NVIDIA Grace. Ускорители выполняют массивные параллельные вычисления, а процессоры обеспечивают работу программ, подготовку данных и взаимодействие с остальной инфраструктурой.
В том же описании приведены примерно 20 ТБ GPU-памяти и около 37 ТБ суммарной быстрой памяти. Это разные показатели. Первый относится к памяти ускорителей, второй характеризует более широкий объём памяти системы. Их нельзя складывать, считать взаимозаменяемыми или трактовать как единый массив, к которому любой GPU обращается с одинаковой скоростью. Точные значения и состав памяти необходимо подтверждать актуальной спецификацией именно DGX GB300 NVL72: характеристики общей платформы не заменяют документацию конкретного продукта.
Логика устройства понятна и без сложной схемы: вычислительные модули с GPU и CPU связаны высокоскоростной сетью обмена, а тепло от компонентов отводится жидкостной системой охлаждения. Здесь важна вся цепочка. Больше ускорителей не всегда означает пропорционально больше полезной производительности, если они ждут данные, синхронизацию или освобождение памяти.
Связующим звеном выступает NVLink пятого поколения. Его задача — обеспечить быстрый обмен между GPU, необходимый при распределении модели и вычислений. Это особенно важно, когда задача слишком велика для одного ускорителя. Однако скоростное соединение не отменяет необходимости грамотно распределять нагрузку: программное обеспечение должно использовать архитектуру системы, а не просто видеть 72 доступных GPU.
Почему петафлопсы ещё не доказывают лидерство
В описаниях современных AI-систем встречаются огромные значения производительности Tensor Core. Здесь принципиально важны обозначения FP4, FP6 и FP8: они указывают на форматы вычислений с низкой точностью, востребованные в определённых сценариях искусственного интеллекта. Такие показатели не описывают универсальную скорость стойки.
Сравнивать их с FP32 или FP64 напрямую нельзя. Научная задача, требующая высокой численной точности, и инференс модели, подготовленной к вычислениям в низкой точности, предъявляют к оборудованию разные требования. Даже внутри AI-нагрузок переход на другой формат зависит от модели, программного стека и допустимого изменения качества результата.
Важна и разница между плотными и разреженными вычислениями. При поддерживаемой структуре разреженности часть операций можно пропускать, поэтому заявленный пик может отличаться от показателя для плотных данных. Пока не установлены режим измерения и учёт разреженности, пиковую цифру нельзя превращать в обещание прикладной скорости.
По этой причине неподтверждённые значения петафлопс и кратности ускорения здесь не используются как доказательство превосходства. Для содержательного сравнения нужны точный формат вычислений, конфигурация, версия ПО и условия теста. А для заявления о рекорде — конкретный независимый результат с названием бенчмарка, категорией и датой. Победа в одном тесте не делает систему самой быстрой во всех задачах.
Зачем модели целая стойка
При обучении большой языковой или мультимодальной модели память нужна не только для её параметров. Место занимают также градиенты, состояния оптимизатора, активации и промежуточные данные. Чем масштабнее модель и сложнее режим обучения, тем важнее возможность распределить эти ресурсы между ускорителями.
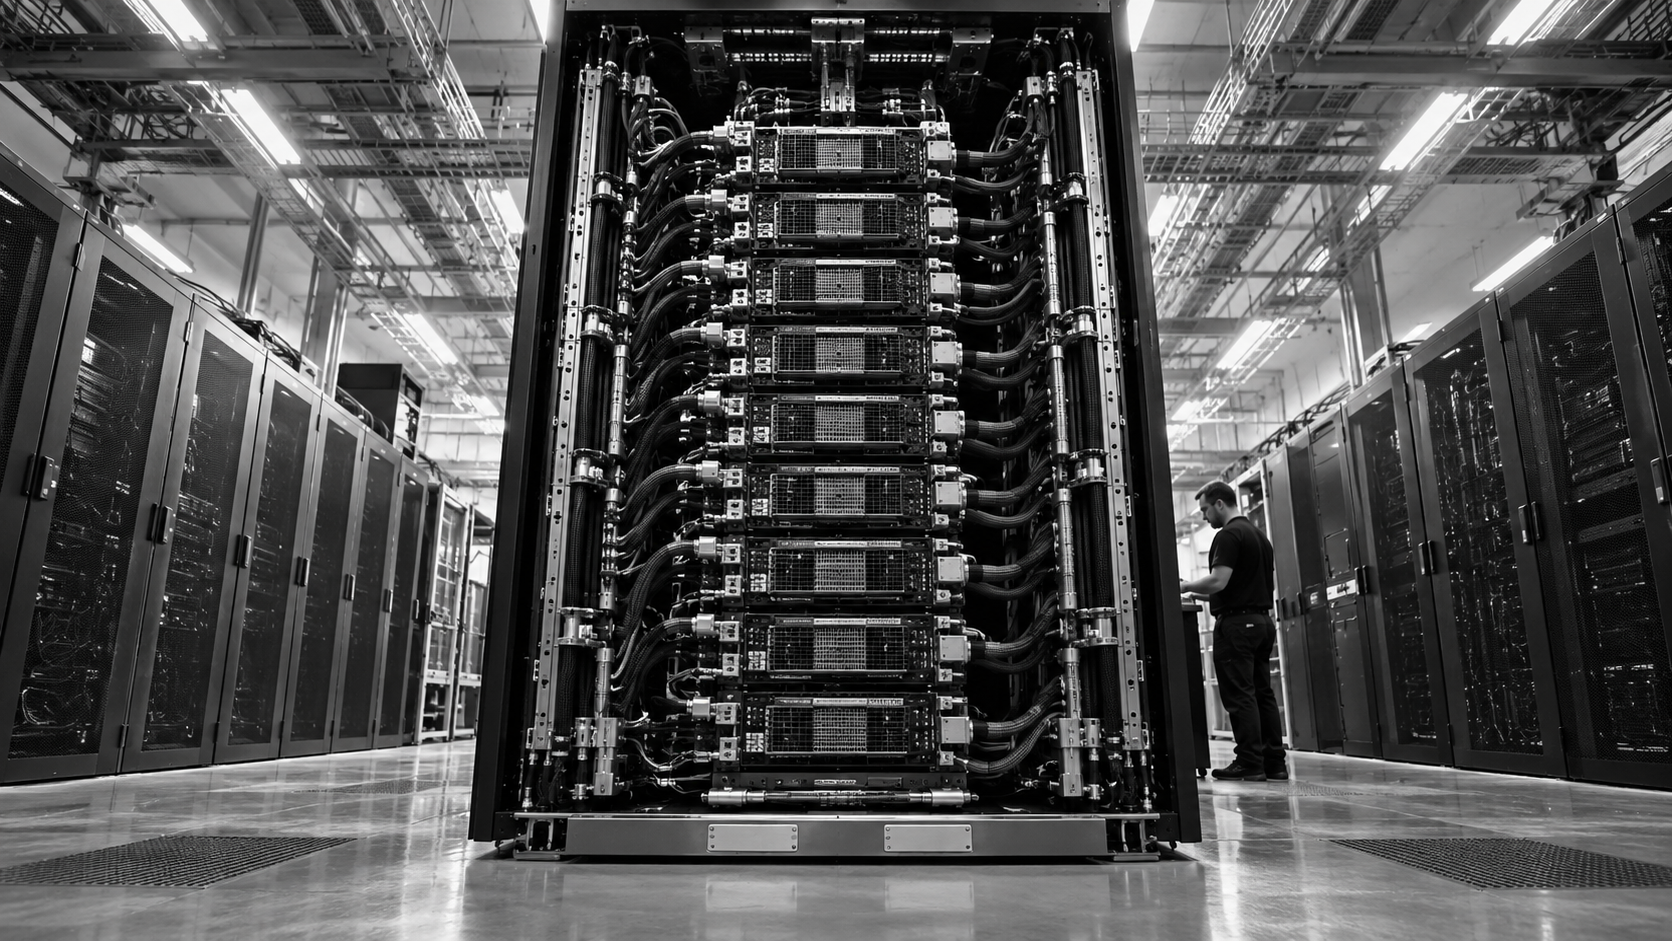
Но распределение создаёт новую нагрузку: GPU приходится обмениваться данными. Если вычисления заканчиваются быстро, а обмен затягивается, дорогие ускорители простаивают. Поэтому сочетание большого объёма памяти и быстрых межсоединений зачастую важнее, чем одна рекордная цифра в спецификации.
В инференсе акценты меняются. Система должна хранить параметры модели, обслуживать запросы и поддерживать данные контекста, включая KV-кэш. Длинные контексты и большое число одновременных пользователей увеличивают требования к памяти. При этом бизнесу нужны не абстрактные операции в секунду, а подходящее сочетание пропускной способности, задержки ответа и качества.
Для одних сервисов приоритетом станет количество обработанных токенов, для других — время до первого токена или стабильность ответа под нагрузкой. Максимальная производительность в пакетном режиме ещё не означает лучший результат для интерактивного помощника.
Именно здесь DGX GB300 NVL72 представляет интерес: система такого масштаба позволяет рассматривать ресурсоёмкие задачи, которым тесно в одном сервере. Однако любая модель не начнёт автоматически эффективно использовать все 72 GPU. Результат зависит от способов параллелизма, точности, библиотек, распределения памяти и характера нагрузки. Иногда меньшая конфигурация окажется рациональнее.
Что понадобится за пределами стойки
Метафора «AI-фабрика в стойке» хорошо передаёт плотность вычислительных ресурсов, но не означает, что стойка заменяет всю инфраструктуру. Ей нужны питание, охлаждение, сеть, хранение данных и эксплуатация.
Для технического руководителя практическая проверка начинается с площадки. Нужно подтвердить доступную электрическую мощность, параметры жидкостного контура и возможность отвода тепла. Затем оценить размещение стойки, доступ для обслуживания, требования к внешней сети и скорость подачи данных из хранилища.
Следующий вопрос — совместимость ПО. Поддерживаются ли нужные модели, форматы точности и способы распределения вычислений? Есть ли мониторинг, управление заданиями и команда, способная обслуживать такую систему? Наконец, важно оценить ожидаемую загрузку: высокая плотность ускорителей приносит пользу только тогда, когда для них есть постоянная работа.
Стоимость, энергопотребление и сроки поставки нельзя надёжно вывести из числа GPU. Для решения о внедрении нужны данные по конкретной конфигурации, площадке и предложению поставщика.
С чем сравнивать DGX GB300 NVL72
Естественная отправная точка — DGX GB200 как предыдущее поколение. Но сравнивать следует одинаковый масштаб и одинаковую нагрузку. Заявленные производителем приросты не заменяют независимого тестирования, особенно если отличаются точность, настройки модели или условия измерения.
Vera Rubin NVL72 стоит учитывать при проверке более нового поколения, однако анонс, готовность продукта и фактическая доступность для поставки — разные статусы. Без их подтверждения нельзя уверенно назначить победителя в категории «самый новый на рынке».
Системы GB300 NVL72 от Lenovo и ASUS следует рассматривать как реализации общей платформы, а не автоматически как независимые технологические альтернативы. Различия могут быть существенны для закупки и эксплуатации, но их нужно устанавливать по конкретным спецификациям. DGX SuperPOD, в свою очередь, нельзя напрямую противопоставлять одной стойке: это другой масштаб инфраструктуры.
Мощность, которую стоит измерить своей задачей
DGX GB300 NVL72 показывает, куда движется высокопроизводительная AI-инфраструктура: от отдельных серверов к тесно связанным системам масштаба стойки. Её привлекательность — в сочетании ускорителей, памяти, межсоединений и охлаждения, а не в одном громком числе.
Но имеющихся сведений недостаточно, чтобы объявить её новейшим доступным GPU-сервером или мировым рекордсменом. Такой вывод требует актуальной проверки рынка, статуса поставок и сопоставимых результатов тестирования.
Оцените материал
Опубликовано на